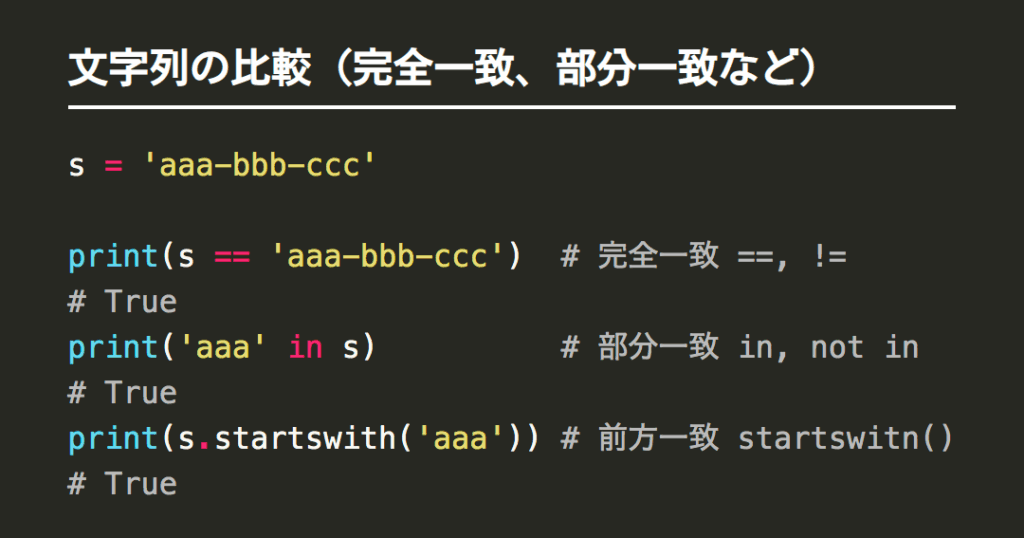
私たちはプログラミングの世界で、文字列を操作することが非常に重要であると感じています。特にpython 部分文字列の取得方法は、データ処理やテキスト解析において欠かせない技術です。このブログ記事では、Pythonを使った部分文字列の取得方法について詳しく解説します。
具体的には、スライス機能やメソッドを活用して、どのように簡単に部分文字列を取り出すことができるのかを紹介します。コード例も交えてわかりやすく説明し、実践的な使用例も提供します。私たちが学ぶこのテクニックは、日常的なプログラミングだけでなく、大規模なデータ分析にも役立つでしょう。
あなたはPythonで部分文字列を扱う際にどんな課題がありますか?その解決策を一緒に見つけていきましょう。
部分文字列を取得する基本的な方法
é¨åæåå¬ã好ü¶ä¼¯ç€
Pythonにおいて、は、スライス機能を活用することです。この方法では、特定のインデックス範囲内での文字列の切り出しが可能となります。例えば、my_string[開始インデックス: 終了インデックス]という構文を使用します。この構文によって、指定した範囲の部分文字列が簡単に得られるため、大変便利です。
スライシングの具体例
以下にPythonでの例を示します:
my_string = "こんにちは世界"
print(my_string[0:5])  # 出力:こんにちは
このコードでは、最初から5番目まで(5番目は含まれない)の文字が取得されます。スライシングは非常に柔軟性があり、負のインデックスも利用できます。これにより、文字列の末尾から数えることも可能になります。
部分文字列検索メソッド
Pythonにはさらに便利なメソッドとしてfind()やindex()があります。これらは特定の部分文字列が存在する位置を返します。
find(substring):指定した部分文字列が見つかった場合、その最初の位置を返し、見つからない場合は-1を返します。index(substring):指定した部分文字列が見つかった場合、その最初の位置を返し、見つからない場合にはエラーを発生させます。
これらメソッドを駆使すれば、大規模なテキスト処理やデータ解析などでも効率よく作業できるようになります。
スライス機能を使った文字列の操?
私たちがPythonを使用する際には、部分文字列の操作に関する知識が不可欠です。特に、文字列内の特定の部分を抽出したり、置換えたりするためのメソッドを理解しておくことが重要です。このセクションでは、主にスライシングと呼ばれるテクニックについて説明します。それによって、任意の範囲の文字を簡単に取得できます。
スライシングによる部分文字列の抽出
my_string[start:end]という形式で指定することで、開始インデックスから終了インデックスまでの部分文字列を取得できます。例えば:
my_string = "こんにちは世界"
print(my_string[0:5])  # 出力:こんにちは
この例では、「こんにちは」という言葉は最初から5番目までの位置にあるため、そのように指定しています。また、この方法は非常に柔軟性があり、負のインデックスもサポートされています。これは後ろから数えて位置を指定できるため、とても便利です。
他のメソッドとの併用
Pythonsではslicingとともにfind(), replace(), split()など、多様なメソッドがあります。これらを組み合わせて使用すると、更なる効率化や検索精度向上につながります。
.find(substring): 指定した部分文字列が最初に現れる位置を返します。.replace(old, new): 指定した古い部分文字列を新しいものと交換します。.split(separator): 文字列を指定した区切りで分割しリストとして返します。
Slicingと各種メソッドを適切に使うことで、私たちはPythonでより高度なテキスト処理が可能になります。このような技術は日常的なプログラミング作業のみならず、大規模プロジェクトでも役立つでしょう。
正規表現による部分文字列の抽出
私たちがPythonを使って処理を行う際に、部分文字列の抽出は非常に重要な技術です。特に、正規表現を利用することで、より柔軟かつ強力な文字列操作が可能になります。正規表現は、特定のパターンにマッチする文字列を検索したり、置換したりするための強力なツールです。
方法
Pythonでは、reモジュールを使用して正規表現を扱います。このモジュールには多くの機能がありますが、その中でもよく使われるメソッドには以下があります:
re.search(pattern, string): 指定したパターンが最初に見つかった位置を返します。re.match(pattern, string): 文字列の先頭でパターンと一致する場合のみマッチします。re.findall(pattern, string): パターンに一致するすべての部分文字列をリストとして返します。
例えば、次のコード例では「数字」を含む部分文字列を抽出しています:
import re

text = "今日は2023年10月5日です。"
numbers = re.findall(r'd+', text)  # 数字を全て抽出
print(numbers) # 出力:['2023', '10', '5']この例からもわかるように、Pythonsで正規表現を用いることで柔軟なデータ処理が実現できます. 特定の条件やパターンに基づいて必要な情報だけを抜き出すことができるため、大量データから必要な情報のみを効率的に取得できます。また、このアプローチは他言語でも類似しており、多様性と互換性があります。
実際的な利用シーンと注意点
Pythonsによる部分文字列の抽出はさまざまな場面で役立ちます。例えば、ログファイルからエラーコードや日時情報だけを書き出す作業などです。しかしながら、正規表現はその構文が直感的ではない場合もあるため、不具合や意図しない結果になることもあります。そのため慎重に設計しテストすることが重要です。
| #種類 | #説明 |
|---|---|
| .search() | 最初の一致位置検索 |
| .match() | 先頭位置で一致確認 |
| .findall() | A全て一致する要素リスト化 |
Pythonsによる部分文字列操作と正規表現技術は、高度なデータ処理能力へ繋がります。我々はこれらの知識とスキルを活用し、プログラミングタスクへの対応力向上につながるでしょう。
実用的な使用例とシナリオ
Pythonにおける分割文字列の扱いは、非常に実用的な応用が豊富です。特に、データ解析やテキスト処理の分野では、文字列を効果的に操作することが求められます。ここでは、私たちが日常生活や業務で直面する具体的な使用例を考えながら、その方法について詳しく解説します。
例えば、CSVファイルからデータを取り込みたい場合を考えてみましょう。この時、Pythonのsplit()メソッドを利用してコンマ区切りで行を分割し、それぞれの値にアクセスすることができます。このプロセスは以下のようになります:
data = "名前,年齢,職業"
fields = data.split(",")  # コンマで分割
print(fields)  # 出力:['名前', '年齢', '職業']
この例からもわかるように、split()メソッドは指定された区切り文字によって文字列を効率良く分割し、新しいリストとして返します。また、この機能は単純なケースだけでなく、複雑なデータセットにも適用可能です。
次に、多くの場合にはユーザー入力から得られる情報も考慮する必要があります。例えば、ユーザーが一連の電話番号やメールアドレスをカンマ区切りで入力した際、それらを個別に処理したいときにも役立ちます。その場合も同様にsplit()メソッドを使用すれば簡単です。
さらに、高度な使い方として正規表現と組み合わせることで、更なる柔軟性があります。例えば、不規則な形式のデータから特定のパターン(電話番号や日付など)だけを抽出することも可能です。この場合にはreモジュールとの併用がおすすめです。
import re

text = "お問い合わせは090-1234-5678またはinfo@example.comまで"
phones = re.findall(r'd{3}-d{4}-d{4}', text)  # 電話番号抽出
print(phones)  # 出力:['090-1234-5678']
このような手法によって、自動化されたデータ収集や整理作業が大幅に効率化されるため、多くのビジネスシーンでも重宝されています。また、この技術はPythonプログラミング全般へ広げて応用できる基礎となります。
最終的には、このような実践的な使用例を通じて私たちはPythonによる部分文字列取得技術の価値とその潜在能力についてより深く理解できるでしょう。そして、この知識こそが私たちの日々の仕事や学習活動で活かされる重要な要素となります。
他のプログラミング言語との比較
Pythonにおける分割文字列処理の技術については、他のプログラミング言語と比べても非常に便利で効率的です。特に、Pythonは文字列を操作するための豊富な機能を備えており、その中でもsplit()メソッドは最も基本的かつ重要な手法の一つです。このメソッドを使用することで、我々は簡単に文字列を指定した区切り文字で分割し、リストとして取得することができます。
他言語との比較
例えば、JavaやC++など他のプログラミング言語では、同様の操作を行う際にはより多くのコードを書く必要があります。以下にいくつかの主要な違いを示します。
- Java: Javaでは、
String.split(String regex)メソッドを用いて分割しますが、この場合正規表現を理解している必要があります。また、結果は配列として返されます。 - C++: C++の場合、標準ライブラリには直接的な方法が存在せず、自作関数を書く必要があります。これには時間と労力がかかります。
このように見ると、Pythonによる分割処理はそのシンプルさから非常に優れた選択肢であると言えます。我々は短いコードで直感的に結果を得られるため、生産性が向上します。加えて、多様なデータ形式(CSVやTSVファイルなど)にも対応できる点も大きな利点です。
さらに、高度なカスタマイズが求められる場合でもPythonではreモジュールを利用して正規表現による柔軟な検索・置換処理が可能です。このアプローチによって複雑なパターンにも簡単に対処できるため、多岐にわたる文字列操作ニーズにも応えることができます。
次に具体例として、他言語と比較した実装例を見ることで、それぞれの手法について深く理解していきましょう。