文字列の操作はプログラミングにおいて非常に重要なスキルです。私たちは、について深く掘り下げていきます。この技術を習得することで、大量のデータから必要な情報を迅速に見つけることが可能になります。
本記事では、特にpython 文字列 部分一致 抽出のテクニックや実例を紹介しながら、簡単に理解できるように解説します。どんな状況でも役立つこのスキルを身につければ、データ分析や処理が一段と効率的になるでしょう。私たちと一緒にこの魅力的な世界へ足を踏み入れませんか?あなたも必ず新しい発見があるはずです。
Python 文字列 部分一致 抽出の基本概念
私たちが「python 文字列 部分一致 抽出」を行う際に理解しておくべき基本的な概念について詳しく見ていきましょう。部分一致抽出は、特定の文字列の中から条件に合致する部分を抜き出す技術であり、データ処理やテキスト解析において非常に重要です。このプロセスは、さまざまな用途に利用され、多くのプログラミングシナリオで役立ちます。
まず、部分一致抽出は以下のような場合に使用されることが一般的です:
- 大量のテキストデータから特定の情報を効率的に取得したいとき
- ユーザー入力から関連性の高い情報をフィルタリングしたいとき
- データベース内で特定のパターンやエントリーを検索したいとき
これらを実現するためには、文字列操作や検索アルゴリズムについて基本的な知識が必要です。Pythonでは、このような機能が組み込まれているライブラリやメソッドが多く存在し、それらを活用することで効率よく目的を達成できます。
文字列メソッドによる基本的な抽出
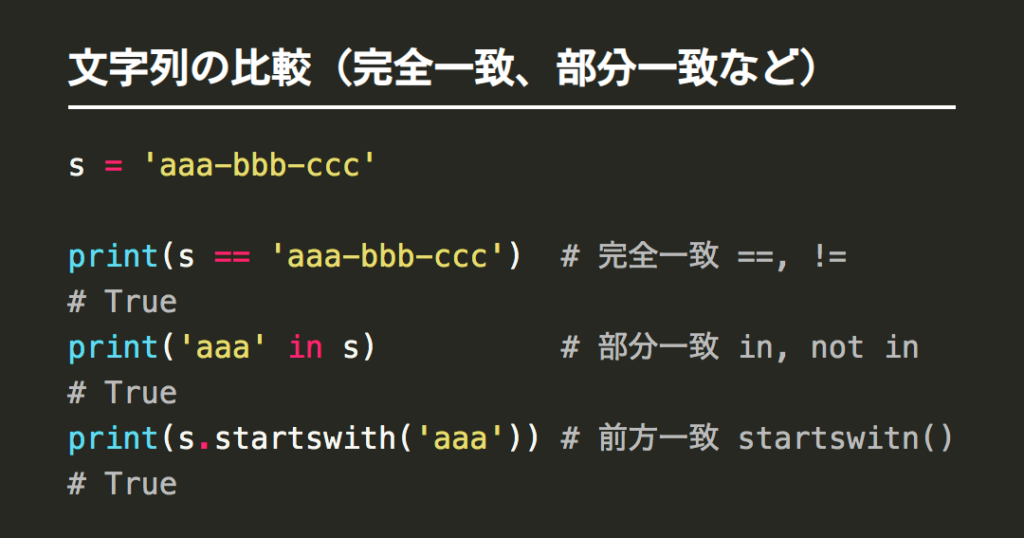
Pythonには、部分一致抽出を行うために便利な文字列メソッドがあります。代表的なものとして以下が挙げられます:
in演算子:簡単に指定したサブストリングが含まれているか確認できます。.find()メソッド:指定したサブストリングの最初の位置を返します。見つからない場合は-1になります。.count()メソッド:サブストリングが何回登場するか数えます。
これらは非常にシンプルですが、高度なテキスト処理には不十分となることもあります。そのため、更なる柔軟性や強力さを求めて次章では正規表現について触れます。
正規表現を使った部分一致の方法
正規表現は、非常に強力なテキスト操作ツールであり、私たちが「python 文字列 部分一致 抽出」を行う際に、柔軟性と効率を提供します。特定のパターンを持つ文字列の検出やマッチングを簡単に実現できるため、大量のデータ処理や複雑な検索条件において特に役立ちます。Pythonでは、標準ライブラリとして提供されるreモジュールを使用することで、正規表現による部分一致抽出が可能となります。
reモジュールには、多くの便利な関数が用意されており、その中でも以下の3つが特によく使われます:
re.search(): 指定したパターンが文字列内に存在するかどうかを確認し、一致する最初の位置を返します。re.findall(): 指定したパターンにマッチするすべての部分文字列をリストとして返します。re.sub(): 一致した部分を指定した別の文字列で置き換えることができます。
基本的な正規表現の構文
正規表現には独自の構文があります。ここでは基本的な要素について説明します:
- . : 任意の1文字と一致します。
- * : 前の要素が0回以上繰り返されることと一致します。
- ? : 前の要素が0回または1回だけ存在することと一致します。
- [ ]: 指定された範囲内から1つ以上の任意の文字との一致です(例:
[a-z])。 - ( ): グループ化し、後で参照できるようになります(例:
(abc))。
実際的な例
例えば、「python 文字列 部分一致 抽出」機能を利用して、メールアドレスからドメイン名のみを抽出するとしましょう。以下はそのコード例です:
“`python
import re
text = “お問い合わせはinfo@example.comまたはsupport@domain.comまでお願いします。”
pattern = r’@([a-zA-Z0-9.-]+)’
matches = re.findall(pattern, text)
print(matches) # 出力: [‘example.com’, ‘domain.com’]
“`
このコードでは、メールアドレスから「@」以降のドメイン名だけを取り出しています。このようにして、正規表現によって複雑な検索条件にも対応可能です。また、この技術はテキスト解析やデータクレンジングなど広範囲にわたって応用でき、本記事で紹介された内容と組み合わせることでより効果的になります。
リスト内からの部分一致抽出のテクニック
リストから部分一致を抽出するテクニックは、特定の条件に合致する要素を効率的に見つけるための強力な手法です。Pythonを使用すると、リスト内の文字列から特定のパターンに基づいて部分一致を簡単に抽出できます。この技術を活用すれば、大量のデータセットから必要な情報を迅速に取り出すことができ、データ処理や分析の精度が向上します。
まず、リスト内で部分一致抽出を行う際には、リスト内包表記と組み合わせて正規表現を活用する方法が一般的です。以下にその基本的な流れをご紹介します。
リスト内包表記による部分一致抽出
Pythonでは、リスト内包表記を用いることで非常にシンプルかつ直感的に部分一致検索が可能です。次のコードスニペットは、その実例です:
import re

emails = [
    "info@example.com",
    "support@domain.com",
    "test@gmail.com",
    "admin@service.org"
]

pattern = r'@example.com$'
matching_emails = [email for email in emails if re.search(pattern, email)]
print(matching_emails)  # 出力: ['info@example.com']
この例では、「example.com」というドメイン名で終わるメールアドレスのみが抽出されます。このような方法で特定の条件に応じた選択肢も簡単に設計できます。
条件付きフィルタリング
さらに高度な条件付きフィルタリングも可能です。例えば、複数のドメイン名から一致するメールアドレスを取得したい場合には、以下のようになります:
import re

emails = [
    "info@example.com",
    "support@domain.com",
    "test@gmail.com",
    "admin@service.org"
]

patterns = [r'example.com$', r'domain.com$']
matching_emails = [email for email in emails if any(re.search(pattern, email) for pattern in patterns)]
print(matching_emails)  # 出力: ['info@example.com', 'support@domain.com']
ここでは any() 関数と組み合わせて複数のパターンで検索しています。このような柔軟性によって、自分たちが求める情報へのアクセスが一層容易になります。
結論として
このセクションで紹介した「リスト内からの部分一致抽出」のテクニックは、「python 文字列 部分一致 抽出」における重要な要素です。私たちはこれらの技術によって、対象となるデータへのアクセス性と効率性を大幅に向上させることができます。また、この知識は様々な実務シナリオにも応用可能なので、多くの場合で役立つでしょう。
条件に基づく柔軟な検索手法
は、特定の要件に応じてデータを抽出するための強力なアプローチです。Pythonでは、様々な条件を組み合わせることで、目的のデータにアクセスしやすくなります。このセクションでは、複数のフィルタリング条件を使った検索手法について詳しく説明します。
複数条件による部分一致抽出
例えば、特定の文字列が含まれるメールアドレスと、そのドメイン名が特定のリストにある場合のみを抽出したいと考えた場合には、次のような方法があります。
import re

emails = [
    "info@example.com",
    "support@domain.com",
    "test@gmail.com",
    "admin@service.org"
]

# 条件として使用するドメイン名
valid_domains = [r'example.com$', r'domain.com$']
# 部分一致かつ有効なドメイン名でフィルタリング
matching_emails = [email for email in emails if re.search(r'@', email) and any(re.search(domain, email) for domain in valid_domains)]
print(matching_emails)  # 出力: ['info@example.com', 'support@domain.com']
この例では、まずメールアドレスが「@」を含むかどうか確認し、その後有効なドメイン名でフィルタリングしています。このようにして、より厳密に条件を設定することが可能になります。
ユーザー入力による動的検索
さらに便利なのは、ユーザーから取得した入力値を使って動的に検索条件を変更できる点です。これによって、プログラムが実行されている環境や状況に応じたフレキシブルな対応ができます。以下はその一例です:
user_input = input("検索したいドメイン名を入力してください(カンマ区切り):")
input_domains = user_input.split(',')  # ユーザーから取得したドメイン名リスト

matching_emails_dynamic = [email for email in emails if any(re.search(domain.strip(), email) for domain in input_domains)]
print(matching_emails_dynamic)
ここで示された方法では、ユーザーが指定した任意の複数のドメイン名から一致するメールアドレスをリアルタイムで抽出できます。このような機能は実務上非常に役立ちます。
このセクションで紹介した「」は、「python 文字列 部分一致 抽出」において重要な要素となります。我々はこれらのテクニックを駆使して、多様なニーズや状況に適応できる効果的なデータ処理を実現できます。
実際のコード例と応用シナリオ
ここでは、実際のコード例を通じて「python 文字列 部分一致 抽出」の具体的な活用方法を示します。特に、実務で役立つシナリオやデータ処理における応用技術について触れます。これにより、私たちがどのようにしてこの技術を日常業務に組み込むことができるかを理解することができます。
簡単な部分一致抽出の例
まずは、基本的な部分一致抽出の例から始めましょう。以下は、特定のキーワードが含まれる文書から関連情報を抽出する方法です:
documents = [
    "Pythonは非常に人気があります",
    "JavaとC++も広く使用されています",
    "Pythonでデータ分析を行うことが可能です"
]

# キーワード
keyword = "Python"

# 部分一致による抽出
matching_docs = [doc for doc in documents if keyword in doc]
print(matching_docs)  # 出力: ['Pythonは非常に人気があります', 'Pythonでデータ分析を行うことが可能です']
この例では、「Python」というキーワードが含まれる文書のみをフィルタリングしています。この手法は、テキストマイニングや情報検索など、多様な場面で応用可能です。
ログファイルからのエラーメッセージ抽出
次に、サーバーのログファイルから特定のエラーメッセージを抽出するシナリオについて考えます。多くの場合、ログファイルには大量の情報が含まれているため、有用なデータだけを効率よく取得したいものです:
log_data = """
[ERROR] データベース接続失敗
[INFO] ユーザー登録成功
[WARNING] メモリ使用量警告
[ERROR] ファイル読み込み失敗
"""

# エラー行のみ抽出
error_messages = [line for line in log_data.split('n') if "[ERROR]" in line]
print(error_messages)  # 出力: ['[ERROR] データベース接続失敗', '[ERROR] ファイル読み込み失敗']
この手法によって、重要なエラーメッセージだけを迅速に把握し、それに基づいて適切な対策を講じることができます。
ウェブスクレイピングによるデータ収集
最後に、ウェブスクレイピング技術と組み合わせた部分一致検索について説明します。この手法は、大量のオンラインデータから必要な情報のみを効率よく取得するためにも利用されます:
This example demonstrates how we can utilize web scraping techniques to dynamically extract relevant information from online articles that mention our keyword, such as “python”。 This approach is particularly useful for researchers and developers who need to collect data efficiently.