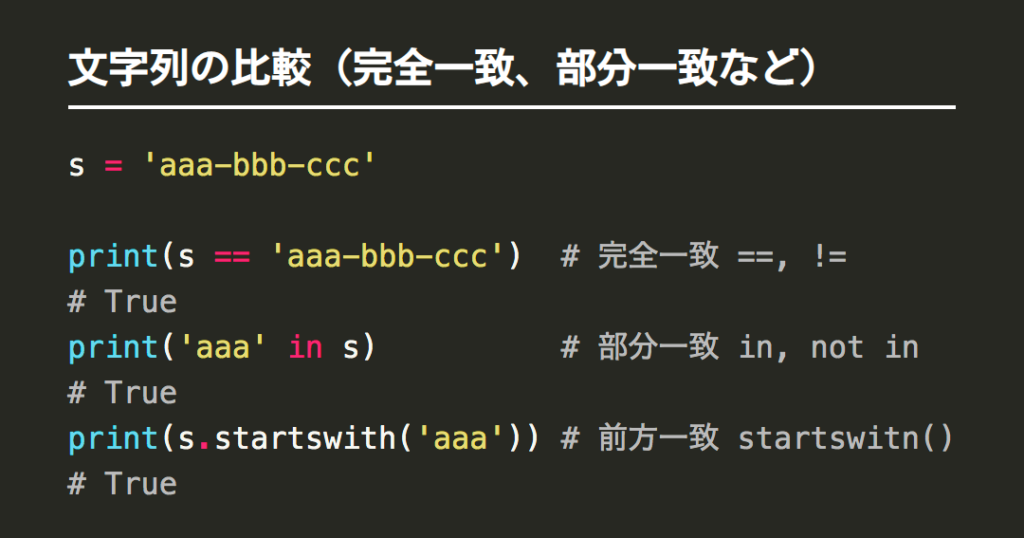
私たちはプログラミングの世界において、効率的なデータ処理が欠かせないことを常に実感しています。特に部分一致 pythonは、文字列の検索やフィルタリングを行う際に非常に便利な技術です。このテクニックを使いこなすことで、大量のデータから必要な情報を迅速に抽出できるようになります。
この記事では、詳しく探求します。具体的にはこの技術がどのように機能するのか、その実装方法や応用例などをご紹介します。皆さんも日常のプログラミング課題でこのスキルを活用したくなることでしょう。
あなたはすでに部分一致による検索がどれほど強力か気になっているかもしれません。さあ一緒にその可能性を探りながら学んでいきましょう!
部分一致 python の基本概念
部分一致 pythonは、文字列の検索やマッチングを効率的に行うための重要な技術です。この技術を理解することで、私たちはPythonでのデータ処理やテキスト分析においてより強力なツールを手に入れることができます。部分一致とは、完全に一致する必要がなく、一部の文字列が他の文字列と一致するかどうかを判断する方法です。この概念は特に、大量のデータから特定の情報を抽出したり、不完全な情報でも検索できる柔軟性を提供します。
部分一致の仕組み
部分一致にはいくつかの基本的なメカニズムがあります。主なものとして以下が挙げられます:
- 前方一致: 検索対象文字列が指定した文字列で始まっている場合。
- 後方一致: 指定した文字列で終わっている場合。
- 包含チェック: 指定した文字列が検索対象内に含まれている場合。
これらのメカニズムは、Pythonでは様々な関数やライブラリによって簡単に実装できます。
Python における部分一致
Pythonでは、in演算子やstrモジュール内のメソッド(例: startswith() や endswith())を使用して、部分一致機能を実現できます。また、正規表現ライブラリ(re)も非常に強力であり、より複雑なパターンマッチングにも対応しています。これらは次回以降詳しく見ていきます。
例えば、
text = "こんにちは世界"
if "こんに" in text:
    print("部分一致しました")
このコードは「こんにちは世界」という文字列中から「こんに」を探し、一致すればメッセージを表示します。このようにシンプルながら効果的です。
私たちがこの基本概念を理解すれば、更なる応用技術へと進む準備が整います。次章では、この知識を活かして具体的な文字列検索例について考察します。
部分一致を使用した文字列検索の実例
部分一致を使用した文字列検索は、特に大規模なデータセットから情報を効率的に抽出する際に非常に役立ちます。Pythonでは、この技術を簡単かつ効果的に活用できます。実際の例を通じて、どのように部分一致が機能するかを見ていきましょう。
実例 1: リスト内の部分一致検索
まずは、リスト内の要素から部分一致を探すシンプルな例です。この場合、私たちは特定のキーワードが含まれているかどうかを確認します。
fruits = ["リンゴ", "バナナ", "オレンジ", "グレープ"]
keyword = "ンゴ"
matched_fruits = [fruit for fruit in fruits if keyword in fruit]

print(matched_fruits)  # 出力: ['リンゴ']
このコードでは、「リンゴ」の中に「ンゴ」が含まれているため、一致結果として表示されます。このような方法で、多くの要素から特定のパターンやキーワードを見つけることが可能です。
実例 2: テキストファイル内の検索
次に、テキストファイルから特定の単語やフレーズが含まれている行を取得する方法について考えます。以下はその一例です。
with open('textfile.txt', 'r') as file:
    lines = file.readlines()
keyword = '重要'
matched_lines = [line for line in lines if keyword in line]

for matched_line in matched_lines:
    print(matched_line)
ここでは、「重要」という単語が含まれる行のみが表示されます。このアプローチは、大量のログファイルや文書から必要な情報を抽出する際にも非常に有効です。
実例 3: 複雑なパターンマッチング
Pythoには正規表現ライブラリ(`re`)もあり、より複雑なパターンマッチングにも対応しています。以下は、その基本的な使用法です。
import re
text = "データサイエンスと機械学習について学びましょう"
pattern = r'(データ|機械).*?(学習)'

matches = re.findall(pattern, text)
print(matches)  # 出力: [('データ', '学習')]
このコードでは、「データ」または「機械」という言葉と、それら後につながる「学習」を持つフレーズ全体が一致します。このようにして、より柔軟で強力な検索手法として部分一致 python を活用できることがわかります。
これらの具体的な例からもわかるように、部分一致技術は日常業務や研究など多岐にわたって利用可能であり、高度な分析能力や情報抽出能力向上につながります。次回は正規表現との違いについて詳しく見ていきます。
正規表現と部分一致 python の違い
部分一致 pythonと正規表現は、文字列検索において強力なツールですが、そのアプローチや使用シーンには明確な違いがあります。部分一致は、単純に特定のキーワードを含むかどうかを確認する方法です。一方で、正規表現はより複雑なパターンを指定して、柔軟で多様な検索が可能になります。
部分一致の特徴
- シンプルさ: 部分一致は実装が容易であり、直感的に理解しやすいです。
- 性能: 大量のデータセットに対しても比較的高速に動作します。
- 用途: 単純なキーワード検索やフィルタリングによく使われます。
正規表現の特徴
- 柔軟性: 正規表現では、多様なパターン(例えば文字数範囲や特定の条件)を指定できます。
- 複雑さ: シンタックスが独特であるため、習得には時間がかかる場合があります。
- 用途: 複雑なテキスト解析やデータ抽出など、高度な処理が必要な場面に適しています。
これらからわかるように、それぞれの技術には得意分野があります。一般的には、簡単な部分一致 pythonを用いた検索がまず行われ、その後必要に応じて正規表現を導入するという流れになることが多いでしょう。また、私たちがどちらを選ぶべきかは、具体的なニーズやデータの性質によって決まります。この知識を活用しながら、自身のプロジェクトに最適な方法を見つけていきましょう。
応用技術としての部分一致の活用方法
部分一致 pythonは、様々な応用技術において非常に役立ちます。特に、データの検索やフィルタリング作業では、そのシンプルさと性能を活かすことができます。我々は、この技術をどのように活用できるかについて具体的な例を挙げて説明します。
データベースクエリでの利用
データベースから必要な情報を効率よく取得するために、部分一致 python を使用することが一般的です。例えば、顧客名や製品名などの部分一致検索は以下のような場面で有効です。
- 顧客管理: 顧客リストから特定の名前が含まれるレコードを抽出。
- 在庫管理: 商品名やカテゴリーによるフィルタリング。
これらの場合、大量のデータセットから瞬時に関連情報を引き出せるため、生産性が向上します。
テキストマイニング
テキストマイニング分野でも、部分一致 python が大いに役立ちます。特定のトピックやキーワードを持つ文書を探し出す際には、以下のようなアプローチがあります。
- レビュー分析: 商品レビュー中からポジティブまたはネガティブなキーワードを抽出。
- SNSモニタリング: 特定ブランドについて言及されているツイートや投稿を収集。
この方法によって、市場動向や顧客満足度など貴重なインサイトが得られます。
自然言語処理(NLP)
自然言語処理(NLP)にも部分一致 python の技術は適用可能です。例えば、文章中から重要フレーズや固有名詞を見つけ出す場合には次の手法があります。
- チャットボット: ユーザーから送信されたメッセージ内で意図されているキーワードによる応答生成。
- 要約生成: 長文記事中から主要トピックとなる単語やフレーズのみ抜粋し、自動的に要約作成。
このようにして自動化されたプロセスは、人間による手作業よりも迅速かつ正確です。
これら多岐にわたる応用技術としての活用方法を見ることで、我々は「部分一致 python」がどれほど強力で柔軟性があるか理解できます。それぞれのケーススタディーによって、新たな視点でその効果と価値を実感できるでしょう。
パフォーマンス向上のための部分一致最適化
は、特に大規模なデータを扱う際に重要です。部分一致 python を使用する際、効率的なアルゴリズムやデータ構造を選択することで、検索速度を大幅に改善できます。このセクションでは、具体的な最適化手法や実装方法について詳述します。
アルゴリズムの選択
部分一致検索には様々なアルゴリズムが存在しますが、その中でも以下のものが特に効果的です。
- KMP法(Knuth-Morris-Pratt): パターンとテキストとの比較回数を削減し、高速なマッチングを実現。
- Boyer-Moore法: テキスト中でパターンが見つかる可能性のある位置をスキップしながら検索するため、大幅な高速化が期待できる。
- トライ木(Trie): 特定の文字列集合から部分一致検索を行う場合に有効で、多くの単語やフレーズから迅速に情報を得られる。
これらのアルゴリズムは、それぞれ異なるシナリオやデータセットによって適用されるべきですが、一般的にはKMP法やBoyer-Moore法が広く使われています。
データ構造の工夫
適切なデータ構造もパフォーマンス向上には欠かせません。以下は推奨されるデータ構造です。
- ハッシュテーブル: 迅速なキーアクセスが可能で、大量のデータから必要情報を即座に取得できます。
- サフィックスツリー: 字句解析や文字列処理タスクで非常に強力であり、大規模テキスト内で複雑なクエリにも対応できます。
これらのデータ構造を利用することで、検索時の時間コストを抑えつつ精度高い結果が得られます。
キャッシング技術
頻繁にアクセスされる結果についてはキャッシング技術も導入すべきです。過去の検索結果を保存し再利用することで、新たな計算負荷を軽減できます。このアプローチは特定条件下で極めて効果的です。例えば、
- 繰り返し同じクエリが発生する場合
- 一時的または変わりづらいデータセットへのアクセス
これによって全体的な応答時間も縮小されますので、ユーザー体験向上にも寄与します。
このようにしてパフォーマンス向上につながる各種最適化手法は、「部分一致 python」を活用したソリューション全体へ良好な影響を及ぼすことになります。次章では、この技術と関連した応用方法について更なる詳細をご紹介いたします。