Pythonを使ってリストから部分一致でデータを抽出する方法は非常に便利です。 私たちは日々のプログラミングやデータ処理においてこの技術を活用しています。特に大規模なデータセットでは、必要な情報を迅速かつ効率的に見つけることが求められます。このブログ記事では「python リスト 部分一致 抽出」の具体的な手法について詳しく解説します。
私たちのアプローチはシンプルで効果的です。 Pythonの基本機能やライブラリを利用してリスト内の要素を部分一致で検索し、目的のデータを容易に取り出す方法をご紹介します。これによって作業効率が格段に向上しますが、実際どのように実装するのでしょうか?次章では具体例とともにその手順を見ていきましょう。
リストの部分一致抽出とは何か
リストの部分一致抽出とは、与えられたリストから特定の条件に合致する要素を取り出す手法です。この方法は、文字列やデータが完全に一致しない場合でも、それらの一部が一致しているものを抽出することが可能です。私たちはこの技術を活用することで、大量のデータから必要な情報を効率よく得ることができます。
一般的には、部分一致抽出は以下のような場面で利用されます:
- データ分析: 大規模なデータセットから特定のパターンやトレンドを見つける。
- 検索機能: ユーザーが入力したキーワードに基づいて関連する結果を表示する。
- フィルタリング: 特定の属性や特徴に基づいて情報を選別する。
このように、私たちの日常業務やデータ処理においても非常に役立つ技術です。次に、Pythonでどのように文字列検索が行われるかについて詳しく見ていきましょう。
Pythonでの文字列検索方法
私たちがPythonを使用してリストの部分一致抽出を行う際、文字列検索は非常に重要な技術です。Pythonには、文字列操作や検索を容易にするための豊富な機能が備わっています。これらの機能を活用することで、大量のデータから必要な情報を迅速に抽出できるようになります。
文字列メソッド
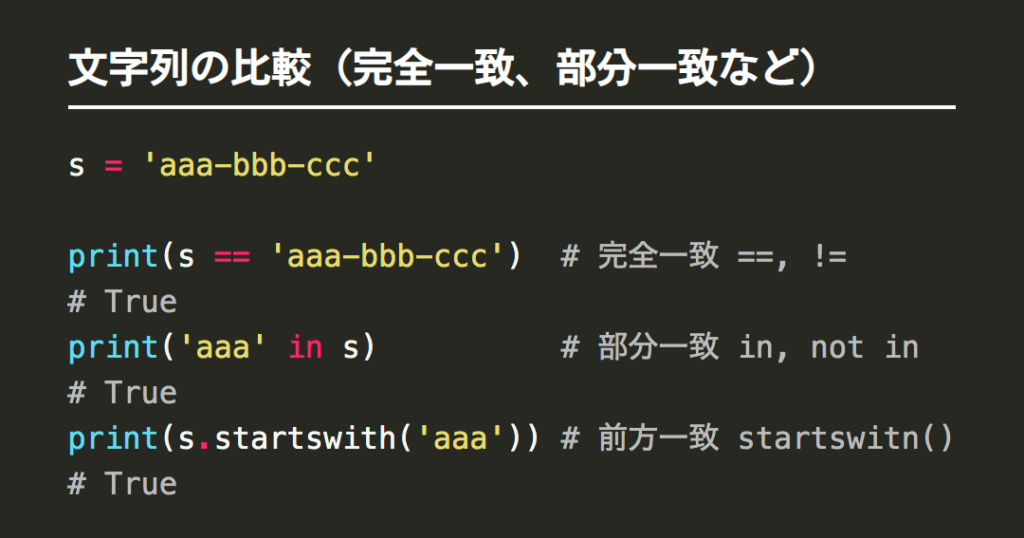
Pythonでは、以下のような基本的な文字列メソッドを使用して部分一致検索が可能です:
in: 特定の文字列が他の文字列内に存在するかどうかを確認します。str.contains(): Pandasライブラリで提供されており、DataFrame内で部分一致検索を行います。str.find()とstr.index(): 指定したサブストリングが最初に現れる位置を返します。
これらのメソッドは、特定の条件に基づいてリストから要素をフィルタリングする際に役立ちます。
リスト内包表記
もう一つ便利なのは、リスト内包表記(List Comprehension)です。この手法を使うことで、簡潔かつ効率的にリストから条件に合致した要素だけを取り出すことができます。例えば次のようになります:
my_list = ["apple", "banana", "cherry", "date"]
filtered_list = [fruit for fruit in my_list if "a" in fruit]
print(filtered_list)  # 出力: ['apple', 'banana', 'date']
この例では、「a」を含む果物のみが新しいリストとして生成されています。
正規表現による高度な検索
さらに、高度なパターンマッチングには正規表現(Regular Expressions)が非常に有効です。Pythonではreモジュールを利用して正規表現による検索や置換処理が可能です。以下はその基本的な使い方です:
import re

text = "apple, banana, cherry, date"
pattern = r'a.*'  # 'a'で始まる任意の文字列
matches = re.findall(pattern, text)
print(matches)  # 出力: ['apple', 'anana']
このコードでは、「a」で始まる全ての単語を見つけています。このように正規表現は柔軟性と強力さがありますので、多様なニーズにも対応できるでしょう。
私たちはこれらの方法やテクニックを駆使しながら、Pythonで効果的かつ効率的なデータ処理と情報抽出が実現できます。それでは次に、特定の条件に基づくフィルタリング技術について詳しく見ていきましょう。
特定の条件に基づくフィルタリング技術
私たちが特定の条件に基づいてフィルタリングを行う際には、しばしばリスト内の要素に対して複数の条件を適用する必要があります。Pythonでは、このようなフィルタリングを効果的に実施するためのいくつかの便利な手法があります。これらの技術を使用することで、より精密なデータ処理が可能となり、特定のニーズに応じた情報抽出が容易になります。
複数条件によるフィルタリング
複数の条件を同時に満たす要素を抽出したい場合、論理演算子(andやor)を活用することが非常に重要です。以下はその一例です:
my_list = ["apple", "banana", "cherry", "date"]
filtered_list = [fruit for fruit in my_list if "a" in fruit and len(fruit) > 5]
print(filtered_list)  # 出力: ['banana']
このコードでは、「a」を含み、かつ長さが6文字以上である果物のみが新しいリストとして生成されています。このようにして、は強力です。
条件付き関数
また、自分自身で関数を作成し、その中で複雑なロジックを実装することもできます。例えば:
def filter_fruit(fruit):
    return "a" in fruit and len(fruit) > 5

filtered_list = [fruit for fruit in my_list if filter_fruit(fruit)]
print(filtered_list)  # 出力: ['banana']
この方法では、一貫したロジックでフィルタリングを行うことができるため、大規模なプロジェクトでも保守性が向上します。
Pandasライブラリによる高度なフィルタリング
データフレーム操作の場合、Pandasライブラリは非常に有効です。特定の列や値について簡単に条件付き検索やフィルタリングができるからです。例えば:
import pandas as pd

data = {'fruits': ["apple", "banana", "cherry", "date"]}
df = pd.DataFrame(data)
filtered_df = df[df['fruits'].str.contains('a') & (df['fruits'].str.len() > 5)]
print(filtered_df)  # 出力: fruits
# 1   banana
このような手法は大量データの処理にも対応しており、高速かつ効率的です。その結果、私たちは必要な情報だけを迅速に取り出すことができます。
これらの技術と手法を組み合わせることで、Python リスト 部分一致 抽出 の目的達成へと近づけるでしょう。それぞれのシナリオやニーズによって最適なアプローチを選択しましょう。
python リスト 部分一致 抽出の実践例
私たちがPythonを使用してリストから部分一致の要素を抽出する際には、実践的な例が非常に役立ちます。ここでは、さまざまなシナリオに基づいた具体的なコードを通じて、その方法を学んでいきましょう。このプロセスは、特定の条件やパターンに基づいてデータをフィルタリングする場合に特に有効です。
文字列の部分一致による抽出
例えば、果物の名前から「a」を含むものだけを抽出したいとします。以下はその実装例です:
my_list = ["apple", "banana", "cherry", "date"]
filtered_list = [fruit for fruit in my_list if "a" in fruit]
print(filtered_list)  # 出力: ['apple', 'banana', 'cherry']
このコードでは、「a」が含まれるすべての果物が新しいリストとして生成されます。このように簡単な条件であれば、一行でフィルタリングが可能です。
正規表現を活用した高度な検索
より複雑なパターンマッチングには、正規表現(regex)を使用できます。これにより、特定の形式やパターンに合致する要素のみを抽出するといった高機能な処理が可能となります。以下はその具体例です:
import re

my_list = ["apple", "banana", "cherry123", "date"]
pattern = r'd+'  # 数字を含むかどうか確認するパターン
filtered_list = [fruit for fruit in my_list if re.search(pattern, fruit)]
print(filtered_list)  # 出力: ['cherry123']
この例では、「数字」を含む果物名のみが選ばれています。このような技術は、大量データ内から必要な情報だけを迅速かつ正確に取り出すためにも有効です。
条件付き関数による柔軟性向上
また、自分自身で条件付き関数を書くことで、更なる柔軟性と再利用性を持たせることも可能です。以下は、その一例です:
def contains_a_and_length_greater_than_5(fruit):
    return "a" in fruit and len(fruit) > 5

filtered_list = [fruit for fruit in my_list if contains_a_and_length_greater_than_5(fruit)]
print(filtered_list)  # 出力: ['banana']
この方法では、複数の条件が組み合わされたロジックによってフィルタリングされるため、大規模プロジェクトでも管理しやすく保守性が向上します。
これらの実践例からわかるように、Python リスト 部分一致 抽出 の手法は多岐に渡ります。それぞれのニーズや状況によって最適なアプローチを選択し、効果的なデータ処理につながるでしょう。
効率的なデータ処理とパフォーマンス向上方法
私たちがPythonを使用してリストから部分一致でデータを抽出する際、効率的なデータ処理とパフォーマンスの向上は重要な要素です。特に大規模なデータセットを扱う場合、適切な手法を選択することで処理速度を大幅に改善できます。ここでは、そのための具体的な方法について説明します。
リスト内包表記の活用
リスト内包表記は、Pythonで部分一致抽出を行う際に非常に便利です。この手法は、可読性が高く、コードの実行速度も速いという利点があります。例えば、大きなリストから特定の文字列を含む要素だけを迅速にフィルタリングしたい場合、一行で実現可能です。
my_list = ["apple", "banana", "cherry", "date"]
filtered_list = [fruit for fruit in my_list if "a" in fruit]
print(filtered_list)  # 出力: ['apple', 'banana']
この例では、「a」を含む果物名のみが新しいリストとして作成されます。このようにシンプルかつ効率的な方法は、多くの場合において有用です。
ジェネレーター式によるメモリ最適化
メモリ使用量が問題となる場合には、ジェネレーター式を利用することも考慮すべきです。これは必要になった時だけ値を生成し、一度に全てのデータをメモリに保持しないため、大規模データセットでも効率的です。以下はその実装例です:
def filter_fruits(my_list):
    for fruit in my_list:
        if "a" in fruit:
            yield fruit

my_list = ["apple", "banana", "cherry", "date"]
for filtered_fruit in filter_fruits(my_list):
    print(filtered_fruit)  # 出力: apple, banana
このアプローチでは、条件に合致する果物名のみが順次生成されるため、大きなデータセットでもスムーズに処理できます。
並列処理によるパフォーマンス向上
さらに、高度な要求や大量データの処理には並列処理技術も役立ちます。concurrent.futures モジュールなどを利用すれば、複数のタスクを同時進行で実行でき、全体的なパフォーマンスが飛躍的に向上します。以下はその基本概念です:
from concurrent.futures import ThreadPoolExecutor

def contains_a(fruit):
    return "a" in fruit

my_list = ["apple", "banana", "cherry123", "date"]

with ThreadPoolExecutor() as executor:
    results = list(executor.map(contains_a, my_list))

filtered_list = [fruit for i, fruit in enumerate(my_list) if results[i]]
print(filtered_list)  # 出力: ['apple', 'banana']
この手法では、それぞれの要素について並列で判定が行われるため、大規模リストへの部分一致抽出が迅速になります。
これらの手法によって、python リスト 部分一致 抽出 に関わるデータ処理はより効率的になり、その結果としてプロジェクト全体のパフォーマンスも向上します。それぞれの場合によって最適解が異なるので、自身のニーズや環境に応じて選択してください。また、新しい技術やライブラリーにも目を配りながら常に改善策を検討していくことが大切です。