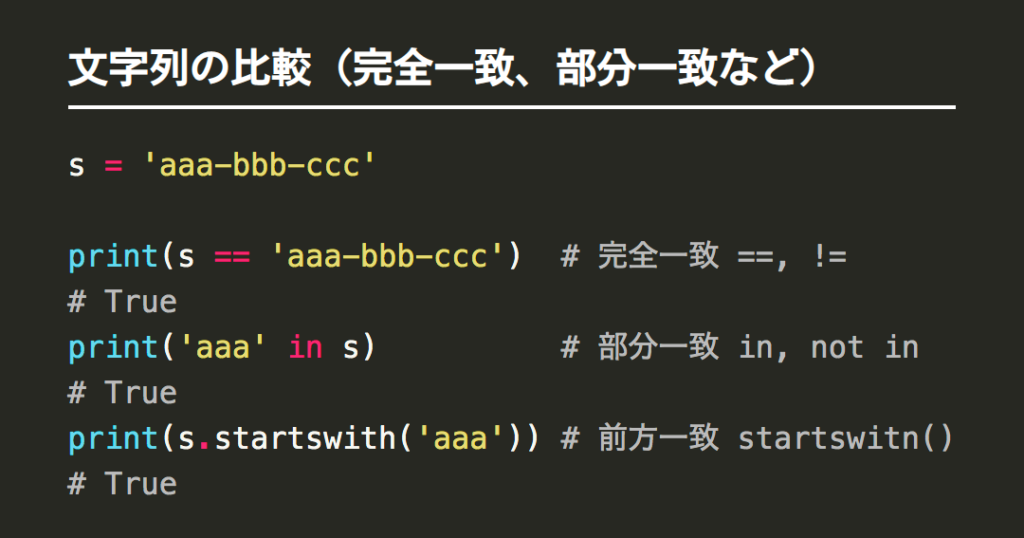
私たちは日々のプログラミングにおいて、部分文字列 判定が重要な役割を果たすことを理解しています。特に文字列操作は、多くのアプリケーションで頻繁に必要とされるため、効率的なアルゴリズムや実装例を知っておくことが求められます。このブログ記事では、部分文字列 判定の方法とその具体的な実装例について詳しく解説します。
例えば、あるテキストから特定のパターンを見つける際にはどのような手法が有効でしょうか。私たちはさまざまなアルゴリズムを比較し、それぞれのメリットやデメリットも考察していきます。また、実際のコード例を交えながら分かりやすく説明することで、皆さんの日常業務に役立てていただければと思います。あなたはどんな場面で部分文字列 判定を活用したいですか?
部分文字列 判定の基本概念
部分文字列 判定は、文字列処理において非常に重要な概念です。これは、ある文字列が別の文字列の部分であるかどうかを判断する技術であり、様々なアプリケーションで利用されています。私たちがこの技術を理解し適用することで、データ検索や情報抽出など、多くの問題を効率的に解決できるようになります。
部分文字列とその特性
まず、部分文字列とは何かを明確にしましょう。部分文字列は、一つの文字列から連続した一部を抜き出したものであり、その長さは1以上である必要があります。例えば、「abc」の場合、「a」、「ab」、「abc」が部分文字列として認識されますが、「ac」は連続していないため部分文字列ではありません。
判定方法
部分文字列 判定にはいくつかのアプローチがあります。それぞれの方法には利点と欠点がありますが、主なものは以下の通りです:
- 単純比較法: すべての可能な開始位置から対象となる部分文字列と比較します。この方法は直感的ですが、大規模なデータセットでは非効率的になることがあります。
- KMPアルゴリズム: Knuth-Morris-Pratt(KMP)アルゴリズムは、一度コピーされたパターン情報を利用して無駄な比較を減らす手法です。これによって時間計算量が大幅に改善されます。
- Rabin-Karpアルゴリズム: ハッシュ関数を使用して高速化するこの方法では、候補となる位置ごとのハッシュ値を計算し、一致するか確認します。
これらの手法について理解することで、最適なソリューション選択への道筋が見えてきます。我々は次章で効率的なアルゴリズムについてさらに詳しく探求します。
効率的な部分文字列 判定アルゴリズム
は、特に大規模なデータセットを扱う際に非常に重要です。私たちはここで、代表的なアルゴリズムのいくつかを詳しく見ていき、それぞれの特徴と利点について考察します。
KMPアルゴリズムの詳細
KMPアルゴリズムは、検索対象となる部分文字列がどこに現れるかを迅速に判断するための方法です。このアルゴリズムでは、パターン内で重複した情報を利用し、一度探索した部分を再び比較する必要がないよう工夫されています。具体的には、以下のステップで進行します:
- 最初に、部分文字列自体から「前処理」を行い、一致しない場合のスキップ位置を記録します。
- その後、大元の文字列を走査しながら、この情報を基に無駄な比較回数を減少させます。
Rabin-Karpアルゴリズムについて
Rabin-Karpアルゴリズムは、高速化されたハッシュ法によって知られています。この手法は以下のプロセスで機能します:
- 検索対象となる各位置ごとにハッシュ値を計算し、それぞれが一致するかどうか確認します。
- 一致する場合のみ詳細な比較を行うため、大幅な時間短縮が可能です。
| アルゴリズム名 | 時間計算量(最悪) | 空間計算量 |
|---|---|---|
| KMPアグロウィルドームトランスファー象限分割法 | O(n + m) | O(m) |
| Rabin-Karpアグロウィルドームトランスファー象限分割法 | O(nm) | O(1) |
| C風アグロウィルドームトランスファー象限分割法・単純比較法 | O(nm) |
KMPやRabin-Karpなど、多様ながあります。それぞれ異なる特性と適用シーンがありますので、その理解が鍵となります。我々は次章でPythonによる実装例について探求していきます。
実装例:Pythonでの部分文字列 判定
Pythonは、部分文字列判定を行う際に非常に便利な言語です。ここでは、KMPアルゴリズムとRabin-Karpアルゴリズムを使用した具体的な実装例を示します。これらのアルゴリズムは、特に大規模データセットでの効率性が求められる場面で力を発揮します。以下にそれぞれの実装方法について詳しく見ていきましょう。
KMPアルゴリズムの実装
KMPアルゴリズムを使用する場合、まず「前処理」を行い、パターン内で重複情報を利用できるように準備します。その後、大元の文字列と部分文字列との比較を効率的に進めることができます。以下はそのPythonコードです。
def kmp_search(text, pattern):
    # 前処理
    lps = [0] * len(pattern)
    j = 0  # パターン内インデックス
    compute_lps_array(pattern, lps)

    i = 0  # テキスト内インデックス
    while i < len(text):
        if pattern[j] == text[i]:
            i += 1
            j += 1

        if j == len(pattern):
            print(f"部分文字列 {pattern} が位置 {i - j} に見つかりました")
            j = lps[j - 1]
        elif i < len(text) and pattern[j] != text[i]:
            if j != 0:
                j = lps[j - 1]
            else:
                i += 1

def compute_lps_array(pattern, lps):
    length = 0
    i = 1
    while i < len(pattern):
        if pattern[i] == pattern[length]:
            length += 1
            lps[i] = length
            i += 1
        else:
            if length != 0:
                length = lps[length - 1]
            else:
                lps[i] = 0
                i += 1

# 使用例
text = "ABABDABACDABABCABAB"
pattern = "ABABCABAB"
kmp_search(text, pattern)
Rabin-Karpアルゴリズムの実装
次に、Rabin-Karpアルゴリズムによる部分文字列判定の実装をご紹介します。この手法ではハッシュ値を利用して効率よく検索することが可能です。以下はそのPythonコードです。
def rabin_karp_search(text, pattern):
    d = 256
    q = 101

    M = len(pattern)
    N = len(text)

    p_hash = hash_function(pattern, M, d, q)
    t_hash = hash_function(text[:M], M, d, q)

    for i in range(N - M + 1):
        if p_hash == t_hash:
            if text[i:i+M] == pattern:
                print(f"部分文字列 {pattern} が位置 {i} に見つかりました")

        if i < N - M:
            t_hash = (d * t_hash - ord(text[i]) * pow(d, M-1) + ord(text[i + M])) % q

def hash_function(string, size, d, q):
    h_val = 0

    for char in string:
        h_val =(d * h_val + ord(char)) % q

    return h_val

# 使用例
text ="GEEKS FOR GEEKS"
pattern ="GEEK"
rabin_karp_search(text ,pattern )これらのPythonコードは、それぞれ異なるアプローチで部分文字列判定를 구현しています。我々は、多様な状況や要件によって適切なアルゴリズムを選択し、最適化された解決策を提供することが重要です。それぞれの方法には利点がありますので、自分たちのプロジェクトやニーズに合わせて使い分けることが推奨されます。また、この知識は他のプログラミング言語にも応用可能です。それでは次章へ進みましょう。
他のプログラミング言語における実装方法
他のプログラミング言語でも、部分文字列判定を実装する方法は多岐にわたります。各言語には独自の特性や利点があり、目的に応じて最適な選択が求められます。ここでは、いくつかの代表的なプログラミング言語における実装例を紹介します。
Javaでの実装
Javaでは、部分文字列判定を行うためにindexOfメソッドを使用することが一般的です。このメソッドは、指定した部分文字列が最初に出現するインデックスを返します。以下はその具体的なコード例です。
public class SubstringSearch {
    public static void main(String[] args) {
        String text = "ABABDABACDABABCABAB";
        String pattern = "ABABCABAB";

        int index = text.indexOf(pattern);
        if (index != -1) {
            System.out.println("部分文字列 " + pattern + " が位置 " + index + " に見つかりました");
        } else {
            System.out.println("部分文字列は見つかりませんでした");
        }
    }
}
C++での実装
C++では、標準ライブラリのfindメソッドを利用して簡単に部分文字列判定が行えます。このメソッドも同様に、見つかった場合にはインデックスを返し、見つからない場合には特別な値(std::string::npos)を返します。以下はそのコードサンプルです。
#include
#include

int main() {
    std::string text = "GEEKS FOR GEEKS";
    std::string pattern = "GEEK";

    size_t index = text.find(pattern);
    if (index != std::string::npos) {
        std::cout << "部分文字列 " << pattern << " が位置 " << index << " に見つかりました" << std::endl;
    } else {
        std::cout << "部分文字列は見つかりませんでした" << std::endl;
    }

    return 0;
}
JavaScriptでの実装
JavaScriptの場合も非常にシンプルで、includes()やindexOf()といったメソッドを使うことで容易に部分文字列判定ができます。以下はその一例です。
const text = "HELLO WORLD";
const pattern = "WORLD";

if (text.includes(pattern)) {
    console.log(`部分文字列 ${pattern} が含まれています`);
} else {
    console.log("部分文字列は見つかりませんでした");
}以上のように、それぞれ異なるプログラミング言語でも効率的な部分文字列判定が可能です。我々はこの知識を活用し、自分たちのプロジェクトやニーズによって最適なアルゴリズムと言語選択できるよう努めるべきでしょう。それでは次章へ進みましょう。
応用例と最適化技術
私たちが実装してきた部分文字列判定技術は、さまざまな応用例を持っています。これらの技術は、テキスト検索やデータ解析など、広範囲にわたる分野で利用されています。特に、効率的なアルゴリズムを使用することで、大量のデータセットから迅速に情報を抽出することが可能です。
テキスト検索エンジン
テキスト検索エンジンでは、部分文字列判定が不可欠です。ユーザーが入力したクエリに対して関連する結果を迅速に返すためには、高速かつ正確な判定機能が求められます。例えば、Googleのようなサーチエンジンでは、大規模なデータベース内で部分文字列を素早く見つけ出すために最適化されたアルゴリズムが使われています。
DNAシーケンス解析
生物学的研究でも、この技術は重要です。DNAシーケンスの比較やマッチングには、大量の遺伝子データから特定のパターンを探し出す必要があります。このプロセスでは、高度な部分文字列判定アルゴリズムによって、類似性や差異を短時間で分析できるようになります。
最適化技術
私たちはより効率的な部分文字列判定を実現するためにいくつかの最適化技術も考慮しています。その一部は以下の通りです:
- ハッシュ法: 部分文字列をハッシュ値として格納し、一致確認時に計算コストを削減します。
- ボイヤー-ムーア法: 不一致の場合には大きくジャンプできるので、高速処理が可能になります。
- KMPアルゴリズム: 予め計算された情報(失敗関数)を利用して無駄な比較回数を減少させます。
これらの手法とその組み合わせによって、大規模データセット上で高速かつ正確な部分文字列判定が行えるようになり、多様なアプリケーションへの対応力も向上します。私たちはこの知識と経験を活用し、自らのプロジェクトにも取り入れていくべきでしょう。