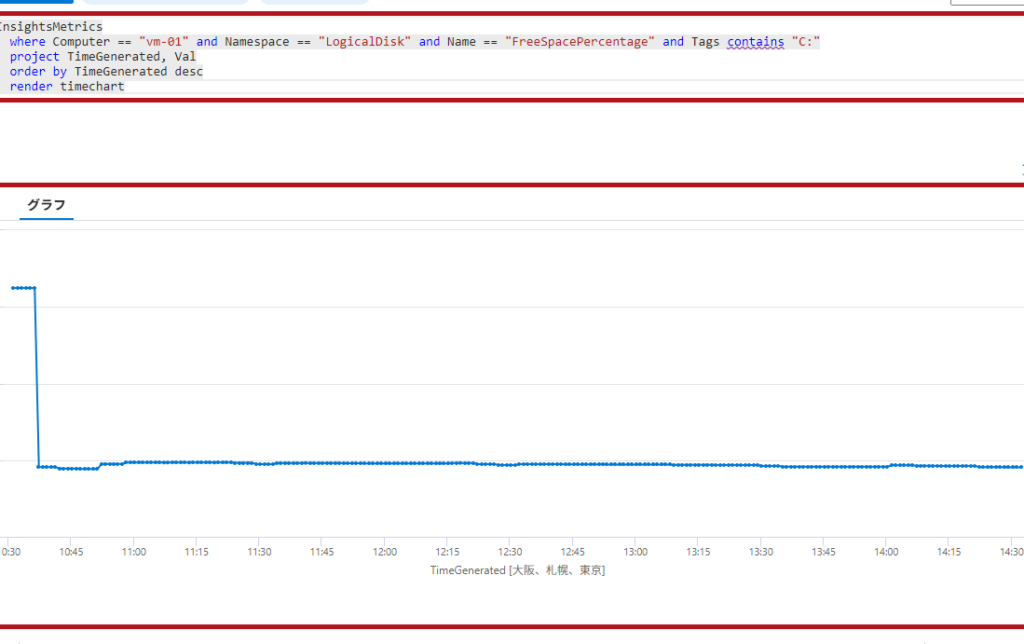
私たちは日々の業務でデータを効率的に検索する必要があります。その中でも kql 部分一致 検索は特に重要です。この技術を活用することで、より柔軟で精度の高い検索が可能になります。KQL(Kusto Query Language)はAzureのログ分析やデータ探索において強力なツールとして知られています。
本記事では、kql 部分一致 の基本的な使い方と具体的な活用例について詳しく解説します。どのようにして部分一致検索を実行し、その結果をビジネスに役立てることができるのでしょうか?この方法を理解することで、私たちのデータ分析能力は一段と向上します。興味深い事例や実践的なヒントも含まれていますので是非最後までご覧ください。あなたも新しい発見があるかもしれません。
KQLでの部分一致検索の基本概念
KQL(Kusto Query Language)における部分一致検索は、データの探索やフィルタリングを行う際に非常に重要な役割を果たします。この機能を利用することで、特定の文字列やパターンを含むデータを簡単に見つけ出すことができ、効率的な分析が可能になります。部分一致検索は、大量のデータセットから必要な情報を抽出するための強力なツールです。
部分一致検索の基本
部分一致検索では、特定の文字列が含まれるレコードを取得できます。これには以下のような方法があります:
- contains: 指定した文字列が含まれているかどうかを判定します。
- startswith: 文字列が指定したサブストリングで始まるかどうかを確認します。
- endswith: 文字列が指定したサブストリングで終わるかどうかを検証します。
これらの関数はそれぞれ異なるシナリオで使用されます。例えば、「contains」を使えば「abc」という単語がどこにでも現れる場合もキャッチできます。一方で、「startswith」は「abc」で始まるエントリーのみへの絞り込みに適しています。このように、それぞれの関数には明確な用途がありますので、目的によって使い分けることが大切です。
使用例
実際には次のようなクエリを書くことになります:
TableName
| where ColumnName contains "searchTerm"
このクエリでは、「TableName」というテーブル内で「ColumnName」に「searchTerm」が含まれる行だけを選択しています。同様に、「startswith」や「endswith」を使用して条件付きフィルタリングも行えます。
私たちはこのような部分一致検索機能によって、大規模データベース内から必要な情報へ迅速アクセスできるため、高度な分析作業にも対応可能となります。また、この手法はユーザー体験向上にも寄与し、より直感的で効率的なデータ操作につながります。
部分一致検索を使用するメリット
私たちは、KQL(Kusto Query Language)の部分一致検索を使用する方法について詳しく説明します。この機能は、特定の文字列が含まれているかどうかを確認するために非常に便利です。部分一致検索は、大量のデータから必要な情報を迅速に抽出する際に役立ちます。
基本的な使い方
部分一致検索を使用するときは、以下のようなシンプルな構文で実行できます:
TableName
| where ColumnName contains "searchTerm"
この例では、「TableName」というテーブル内の「ColumnName」列が「searchTerm」を含むすべての行がフィルタリングされます。このようにして、特定のキーワードやフレーズを持つデータのみを取得できます。
KQLによる他の比較演算子
KQLでは、部分一致検索以外にもさまざまな比較演算子があります。具体的には次のものがあります:
- startswith: 指定した文字列で始まる場合にマッチします。
- endswith: 指定した文字列で終わる場合にマッチします。
これらの演算子も併用することで、より精度高くデータを絞り込むことが可能です。例えば、startswith "abc"と指定すれば、「abc」で始まるすべてのエントリが選択されます。
応用例
KQL の部分一致検索機能は、多くの場合リアルタイム分析やダッシュボード作成などで利用されています。例えば、ログファイルから特定の日付やイベントタイプだけを抽出したい場合、この機能が役立ちます。また、大規模データセット内でも高速かつ効率的に情報を見つけ出すことができるため、多様なビジネスニーズにも対応しています。
KQL の部分一致検索は、その簡単さと効果的な結果から広く利用されています。この技術によって、大量データから価値ある洞察を引き出し、意思決定プロセスを支援することが可能となります。
KQL 部分一致の具体的な構文
KQL(Kusto Query Language)におけるé¨åä¸è´は、データの検索や分析を行うための強力な機能です。この機能を利用することで、私たちは特定の条件に基づいてデータセットから必要な情報を迅速かつ効率的に抽出することができます。具体的には、条件付きでデータをフィルタリングし、求める結果のみを表示させる操作が可能です。
実際の使用例
KQLでのé¨åä¸è´は多様なシナリオで活用されます。例えば、大規模なログデータから特定のエラーメッセージだけを取得したい場合、以下のようなクエリを書きます:
Logs
| where Message contains "Error"
この例では、「Logs」というテーブル内から「Message」列に含まれる「Error」という文字列があるすべての行を抽出します。このようにして、私たちは無駄なく必要な情報へアクセスできるわけです。
KQLによるデータ分析
KQL é¨åä¸è´は単なる検索だけでなく、高度な分析もサポートしています。たとえば、複数の条件を組み合わせてより精緻な結果を得たい場合には、次のクエリが役立ちます:
Logs
| where Timestamp > ago(1d) and Severity == "Critical"
このクエリでは、過去24時間以内に記録された重大(Critical)レベルのログメッセージのみが抽出されます。このようにして、自分たちが直面している問題点やトレンドを明確化し、それらへの迅速な対応策を講じることができます。
パフォーマンス向上への寄与
KQL é¨åä¸è´は大規模データセットでも優れたパフォーマンスを発揮します。適切なインデックス付けや最適化されたクエリを書くことで、大量の情報から瞬時に有用な洞察を引き出すことが可能になります。また、このプロセスには計算コストも伴いますので、その点にも留意する必要があります。
活用例:実際のクエリとその結?
KQL(Kusto Query Language)を用いた実際の運用例は、私たちがデータを効果的に分析し、問題解決に役立てるための強力な手段です。具体的には、ログデータやメトリクスから重要な情報を抽出する際に非常に有効です。以下では、いくつかの実際の使用シナリオとその効果について詳しく説明します。
運用例1:エラーログのフィルタリング
私たちは、大量のログデータから特定のエラーを迅速に見つけ出すことが求められます。以下は、その一例です:
Logs
| where Message contains "Error"
このクエリでは、「Logs」テーブル内で「Message」列に「Error」を含む行だけを抽出しています。このようなフィルタリングによって、問題箇所を特定しやすくなり、迅速な対応が可能になります。
運用例2:クリティカルエラーの追跡
KQLは時間範囲を指定して重要なイベントを追跡することも得意としています。一つの例として、過去24時間以内に発生したクリティカル(Critical)エラーのみを抽出するクエリがあります:
Logs
| where Timestamp > ago(1d) and Severity == "Critical"
ここで「Timestamp」はログが記録された時刻、「Severity」はその重要度レベルです。このように条件付きでデータを絞り込むことで、高優先度の課題への対処が容易になり、業務効率向上につながります。
運用例3:トレンド分析
KQLでは長期間にわたるデータ分析も行えます。我々は一定期間ごとのメトリクス変化を見ることで、新しい傾向や異常値を把握できます。例えば:
Metrics
| summarize AvgValue = avg(Value) by bin(Timestamp, 1h)
This query allows us to analyze the average value of a metric over one-hour intervals. By visualizing this data, we can identify trends and make informed decisions based on historical performance.
KQLによるこれらの実際的な適用は、多様なビジネスニーズにも応じて柔軟に対応できるため、多くの場合最適なソリューションとなります。私たちは、この言語とその機能性のおかげで、より良い意思決定とシステム改善が可能になることを期待しています。
トラブルシューティングとベストプラクティス
KQLの機能を活用することで、我々はデータ分析をより効率的かつ効果的に行うことができます。具体的には、KQLは様々なデータソースにアクセスし、それらの情報を迅速に照会できる強力なツールです。以下では、KQLの基本的な構文や使用法について詳しく説明します。
基本構文
KQLのクエリは直感的であり、主に以下の要素から構成されています:
- テーブル名: データが格納されているテーブルを指定します。
- 演算子: データに対して実行する操作(例:where, project, summarizeなど)を指定します。
- フィルタリング条件: 必要なデータのみ取得するための条件式です。
例えば、次のようなクエリがあります:
Logs
| where Level == "Error"
| project Timestamp, Message
このクエリでは、「Logs」テーブルから「Level」が「Error」であるレコードのみを取得し、その中から「Timestamp」と「Message」列だけを表示しています。このように、KQLは特定の情報へ迅速にアクセスするための非常に便利な手段となります。
KQLによる集約と分析
KQLではデータ集約も容易であり、大量のログやメトリックデータから有意義な洞察を得ることが可能です。たとえば、以下のクエリでは指定した時間範囲内で発生したイベント数を集計しています:
Events
| where Timestamp > ago(7d)
| summarize Count = count() by EventType
このようにして得られた結果は、異なるイベントタイプごとの発生頻度を見ることができ、それによってシステム状態やパフォーマンス問題などへの理解が深まります。また、このプロセスはダッシュボード上で視覚化することでさらに分かりやすく提示できます。
KQLとその他ツールとの統合
KQLはAzure MonitorやLog Analyticsなど、多くのMicrosoft製品と統合可能です。これによって、一元管理されたプラットフォーム上で複数ソースから収集したデータへ効果的にアプローチすることができるため、生産性向上につながります。我々としても、この統合された環境を活用することで、より豊富なインサイトを引き出せるでしょう。